定义类层次:容易踩的坑
先记住一句话:子类 = 父类的「一种」
这一章讲第 3 步中“定义类与类层次”(也就是方法论的第 4 步)时容易犯的错和要留心的地方。
原文重申:任何给定领域都不存在唯一正确的类层次。层次取决于:本体可能怎么用、应用需要多细的粒度、个人偏好,有时还取决于与其他模型的兼容性要求。
下面这些是建层次时应该记在心里的准则。在定义了一大堆新类之后,退后一步,检查一下正在成形的层次是否符合这些准则,是很有帮助的。
4.1确保类层次是正确的
“是一种”(is-a)关系
类层次表达的是“is-a”关系:如果 A 的每个实例也都是 B 的实例,那么 A 是 B 的子类。 比如 Chardonnay(霞多丽)是 White wine(白葡萄酒)的子类。
这个分类关系的另一种理解方式是“kind-of”(一种)关系:Chardonnay 是白葡萄酒的一种;喷气客机是飞行器的一种;肉是食物的一种。
一个类的子类,代表的是父类所代表概念的“一种”。
错误 A:单数不能是复数的子类
一个常见的建模错误,是在层次里同时放同一个概念的单数版和复数版,并让前者成为后者的子类。比如,定义 Wines 类,再定义一个 Wine 类作为 Wines 的子类——这是错的。一旦你把层次理解成“kind-of”关系,这个错误就一目了然了:一款酒不是“酒们”的一种。 避免这类错误的最好办法是:命名类的时候,一律用单数或一律用复数(命名问题的详细讨论见第 6 章)。
特性 B:层次关系是可传递的
子类关系是传递的:
如果 B 是 A 的子类,C 是 B 的子类,那么 C 是 A 的子类。
比如定义 Wine 类,再定义 White wine 是 Wine 的子类,然后定义 Chardonnay 是 White wine 的子类。子类关系的传递性意味着:Chardonnay 也是 Wine 的子类。
有时候我们会区分直接子类和间接子类。直接子类是“最近的”子类——层次中在这个类和它的直接子类之间没有别的类。换句话说,一个类和它的直接父类之间,在层次里没有其他类。在上面的例子里,Chardonnay 是 White wine 的直接子类,不是 Wine 的直接子类。
层次会演化
随着领域演化,保持类层次的一致性可能变得很有挑战性。 原文的例子特别典型:很多年来,所有的仙粉黛(Zinfandel)都是红酒。于是我们把 Zinfandel 类定义为 Red wine 类的子类。但后来,有些酿酒师开始压榨葡萄、立刻抽走产生颜色的那部分,从而改变了成品酒的颜色。于是出现了“白仙粉黛”,它的颜色其实是桃红色。现在我们就得把 Zinfandel 类拆成两个:White zinfandel 和 Red zinfandel,并分别把它们归类为 Rose wine 和 Red wine 的子类。
类 vs. 类的名字
区分一个类和它的名字,很重要:
类代表的是领域中的概念,而不是指代这些概念的那些词。
如果我们换一套术语,类的名字可以变,但那个术语所代表的客观现实不变。比如我们建了一个 Shrimps(虾)类,然后把它改名成 Prawns(对虾)——这个类代表的还是同一个概念。所有涉及虾的菜品搭配,改名后就应该指向对虾的菜品。更实用地说,下面这条规则应该永远遵守:同一个概念的同义词,不代表不同的类。
同义词只是同一个概念或术语的不同叫法。 因此,我们不应该同时有叫 Shrimp 的类、叫 Prawn 的类,可能还有一个叫 Crevette 的类。应该是只有一个类,叫 Shrimp 或者叫 Prawn。很多系统允许给一个类关联一列同义词、翻译或展示名。如果系统不支持这种关联,同义词总是可以写在类的文档(documentation)里。
Shrimp / Prawn / Crevette 是三个标签,一个概念。建成三个类,等于宣称世界上存在三种不同的东西——这是错的。错误 C:类层次里不能有环
我们应该避免类层次里出现环(cycle)。 当类 A 有一个子类 B,同时 B 又是 A 的父类时,我们就说这个层次里出现了一个环。在层次里造出这样一个环,等于宣布 A 和 B 这两个类是等价的:A 的所有实例都是 B 的实例,B 的所有实例也都是 A 的实例。确实如此:既然 B 是 A 的子类,B 的所有实例都必须是 A 类的实例;既然 A 是 B 的子类,A 的所有实例也必须都是 B 类的实例。
4.2分析类层次里的“兄弟”类
兄弟类必须在同一个抽象层级
层次里的兄弟(siblings),指的是同一个类的直接子类。
层次里所有的兄弟类(根节点下的除外),必须处在同一个抽象层级上。
比如,White wine 和 Chardonnay 不应该是同一个类(比如 Wine)的子类,因为 White wine 是比 Chardonnay 更一般的概念。兄弟类应该代表“顺着同一条线”的概念,就像书里同一级的章节处在同一个一般性层级上一样。从这个意义上说,类层次的要求和一本书目录大纲的要求是类似的。
不过,层次根部的那些概念(通常表示为某个非常一般的类如 Thing 的直接子类)代表的是领域的主要划分,它们不必是相似的概念。
几个算太多、几个算太少
一个类应该有几个直接子类,没有硬性规定。 但很多结构良好的本体,直接子类的数量在两个到十几个之间。于是有两条准则:
如果一个类只有一个直接子类,可能存在建模问题,或者本体还不完整。
如果某个类的子类超过十几个,那么可能需要补充中间类别。
第一条规则类似于排版规则:项目符号列表永远不该只有一个条目。 原文的例子:大多数勃艮第红酒都是金丘(Côtes d'Or)的酒。假设我们只想表示这一类占多数的勃艮第酒,可以建一个 Red Burgundy 类,然后建一个唯一的子类 Cotes d'Or(图 6a)。但是,如果在我们的表示里,“勃艮第红酒”和“金丘酒”本质上就是等价的(所有的勃艮第红酒都是金丘酒,所有金丘酒都是勃艮第红酒),那么建 Cotes d'Or 这个类就没有必要,也没有给表示增加任何新信息。如果我们要把夏隆内丘(Côtes Chalonnaise)也纳进来——那是金丘南边产区的、更便宜的勃艮第酒——那么我们就会给 Burgundy 类建两个子类:Cotes d'Or 和 Cotes Chalonnaise(图 6b)。
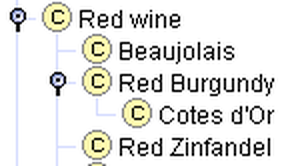
Cotes d'Or。一个类只有一个子类,通常意味着建模有问题。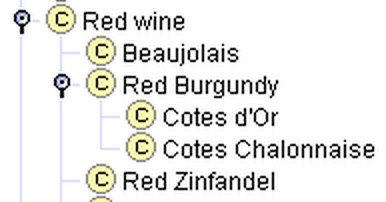
Cotes d'Or 和 Cotes Chalonnaise——这才是正常形态。Cotes d'Or 和 Red Burgundy 完全等价);(2) 你的本体还只建了一半,本来该再有一个兄弟的(如 6b 的 Cotes Chalonnaise)。两种都需要你回头看一眼。再看另一端。假设我们把所有类型的酒都直接作为 Wine 类的子类列出来。这张列表里既包括比较一般的酒类型(如 Beaujolais 和 Bordeaux),也包括更具体的类型(如 Paulliac 和 Margaux)——这就是兄弟类不在同一抽象层级的问题。Wine 类的直接子类太多了,而且,为了让本体更有条理地反映各种酒的类型,Medoc 应该是 Bordeaux 的子类,Cotes d'Or 应该是 Burgundy 的子类。引入 Red wine 和 White wine 这样的中间类别,也会反映很多人对酒这个领域的概念模型(图 7b)。
不过,如果在长长的兄弟列表里,确实不存在能把这些概念归并起来的自然类别,那就不必造人为的类——就让它们那样待着。 毕竟,本体是真实世界的反映;如果真实世界里的确没有这种分类,本体就应该如实反映这一点。
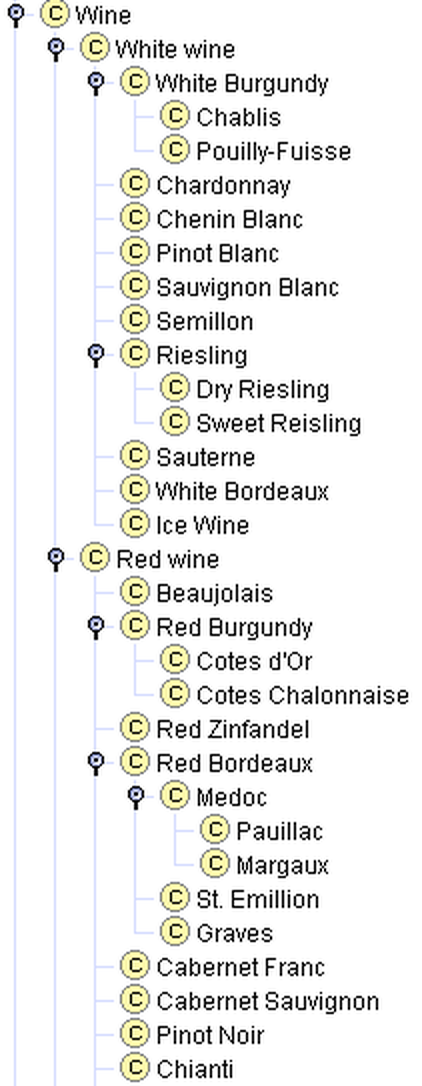
White wine、Red wine、Medoc、Red Burgundy)把细分类型分组。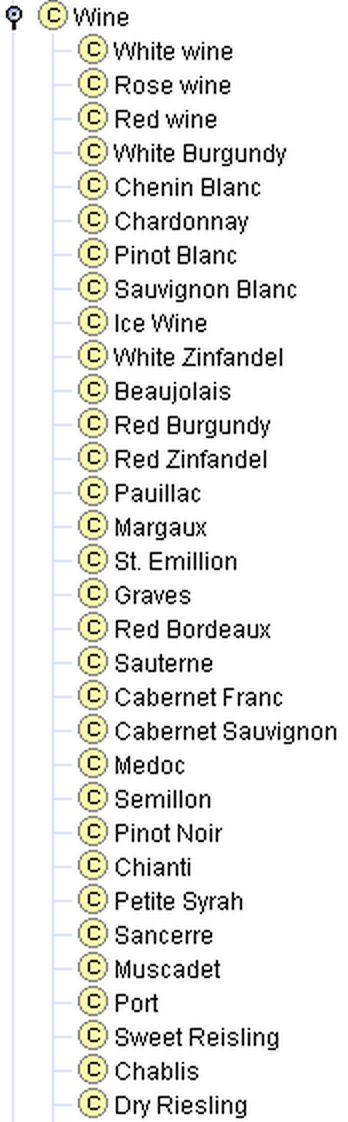
Wine 的直接子类,既没有中间层,也分不出抽象层级。平铺的代价:谁都能看出来“
Medoc 和 Margaux 不是一回事”(一个中间、一个具体),但机器看不出来——它只知道这些都是 Wine 的子类。分层的收益:中间层把“一般 vs 具体”这个信息编码进了结构里,机器也能算了。但最后那条提醒同样重要:别为了分层而分层。 如果现实里真的没有自然的中间类别,硬造一个只会让本体更难维护。
4.3多重继承
多数知识表示系统允许类层次中的多重继承(multiple inheritance):一个类可以是好几个类的子类。 假设我们想为甜酒单独建一个类 Dessert wine。波特酒(Port)既是红酒又是甜酒,因此我们定义 Port 类有两个父类:Red wine 和 Dessert wine。Port 类的所有实例,将同时是 Red wine 类和 Dessert wine 类的实例。Port 类会从它的两个父类继承属性及其约束。于是,它会从 Dessert wine 类继承到 Sugar 属性的值 SWEET,并从 Red wine 类继承到 tannin level 属性以及 color 属性的取值。
〔译注〕原文脚注 4:本书的示例本体里只表示了红波特酒——白波特酒确实存在,但极为罕见。
注意它和 4.8 节“互斥子类”的对比:多重继承说的是“允许同时属于”,互斥说的是“禁止同时属于”。 两者是一对反义词。
4.4什么时候该(不该)新建一个类
建模过程中最难的决策之一,就是判断该新建一个类,还是该用一个不同的属性值来体现这个区分。 在两个坑之间走钢丝很难:一个是嵌套极深、塞满多余类的层次;另一个是非常扁平、类太少、信息全挤在属性里的层次。找到合适的平衡点并不容易。
以下几条经验法则可以帮助判断:
一个类的子类通常:(1)拥有父类没有的额外属性;或(2)拥有与父类不同的约束;或(3)参与和父类不同的关系。
Red wine 可以有不同的单宁含量等级,而这个属性不用来描述一般的酒。Dessert wine 的 sugar 属性的值是 SWEET,而这一点对 Dessert Wine 类的父类并不成立。Pinot Noir 可能适合配海鲜,而其他红酒不行。换句话说:我们通常只在“关于这个类能说点什么、而关于它的父类说不了”的时候,才在层次里引入一个新类。
实操层面:每个子类要么新增了属性,要么定义了新的属性值,要么覆盖了继承来的某些属性的约束。
例外:有时不给新属性,也该建类
不过,有时候即使新类不引入任何新属性,建它也是有用的:
术语层次中的类不必引入新属性。
比如,有些本体包含领域内常用术语的大型参照层次。一个电子病历系统底下的本体,可能包含各种疾病的分类。这个分类可能就只是一个术语层次,没有属性(或者所有术语共用同一组属性)。即便如此,把术语组织成层次,也比拉一张平表有用,因为它能:1. 让浏览和导航更容易;2. 让医生能方便地选择适合当前情形的那个抽象层级的术语。
引入无新属性类的另一个理由:为了表示领域专家习惯上会做的区分,哪怕我们自己已经决定不去建模那个区分本身。既然我们用本体来促进领域专家之间、以及领域专家与知识系统之间的沟通,我们就希望本体能反映专家对领域的看法。
最后,不应该为了每一个额外的约束就建一个子类。 比如我们引入了 Red wine、White wine、Rose wine 这些类,是因为这个区分在酒的世界里是自然存在的。我们没有为“清淡的酒”“中等酒体的酒”等等建类。定义类层次时,我们的目标是在“建出的类有助于组织分类”和“建的类太多”之间取得平衡。
三种“有话可说”分别是:多一个属性(红酒多一个单宁含量)、多一个限制(甜酒的糖分被钉死为甜)、多一种关系(黑皮诺能配海鲜)。
但“有话可说”不是唯一理由。还有两种“沉默但必要”的情况:参照层次(疾病分类这种纯术语树,不增加信息,但方便人挑粒度)、专家共识(专家嘴上会区分、但你的应用用不上——照建,因为专家要用这套词汇交流)。
反面例子同样重要:别为每一个约束建类。 否则你会得到
DelicateWine、ModerateWine……无穷无尽。4.5新建一个类,还是加一个属性值?
建模时经常要决定:某个区分(比如白、红、桃红)该建成属性值,还是建成一组类。这个问题又回到领域范围和手头任务上。
到底该建 White wine 类,还是只建 Wine 类并给 color 属性填不同的值?答案通常取决于我们为本体定义的范围。 关键在于:“白葡萄酒”这个概念在我们的领域里有多重要? 如果酒在这个领域里只是边缘角色,而且“是不是白的”对酒与其他对象的关系没有任何特别影响,那就不该为白葡萄酒单建一个类。举个例子:一家印酒标的工厂用的领域模型,任何颜色的酒标规则都一样,这个区分就不重要。
反过来,如果做的是“酒、食物及其搭配”,那么红酒和白葡萄酒非常不同:搭配的食物不同、属性不同,等等。类似地,如果要建“用于确定品酒顺序”的酒知识库,酒的颜色就很重要。因此要给 White wine 单独建一个类。
如果带着不同属性值的那些概念,会成为其他类中不同属性的限制条件,那我们应当为这个区分建一个新类。否则,就在属性值里表示这个区分。
类似地,本书的酒本体里有 Red Merlot 和 White Merlot 这样的类,而不是一个笼统的 Merlot 类:红梅洛和白梅洛确实是不同的酒(用同一种葡萄酿成),如果我们建的是一个细致的酒本体,这个区分就很重要。
如果一个区分在领域里很重要,并且我们会把在该区分上取不同值的对象看作是不同种类的对象,那我们就应当为这个区分建一个新类。
考虑一个类潜在的个体实例,也有助于判断该不该引入新类。
一个个体实例所属的类,不应该经常变。
通常,当我们用概念的外在属性(extrinsic)而不是内在属性来区分类时,这些类的实例就会频繁地在类之间迁移。比如,在一张描述餐厅里酒瓶的本体中,不应该有 Chilled wine(冰镇酒)这个类。chilled 属性应该就是“瓶中酒”的一个属性值而已——因为一个 Chilled wine 的实例可以很容易地不再是这个类的实例,然后又变回这个类的实例。
通常,数字、颜色、地点都是属性值,不会导致新建类。 不过,酒是个显著的例外,因为颜色对酒的描述来说太重要了。
再看一个例子:人体解剖学本体。表示肋骨时,我们是为“第 1 左肋”“第 2 左肋”……每根都建一个类?还是建一个 Rib 类,配 order(序号)和 lateral position(左右位置)两个属性?如果本体里要表示的每根肋骨的信息差别很大——比如要表示相邻关系、位置信息(每根都不同)、每根肋骨的具体功能、以及它所保护的器官——那就确实该为每根肋骨建一个类。如果建模的抽象层级稍低一些,而且就我们可能的应用而言所有肋骨都很相似(只是讨论 X 光片上哪根肋骨断了,不涉及身体其他部位的推论),那就可以简化层次,只保留 Rib 类,配两个属性:lateral position、order。
〔译注〕原文脚注 5:这里假设每个解剖器官是一个类,因为我们还想谈论“约翰的第 1 左肋”。具体活人的器官个体,在本体里表示为个体实例。
判断“该建类还是该建属性值”,不用靠感觉,问一个问题就够了:这个类的成员资格会频繁变化吗?
·
RedWine:一瓶红酒不会变成白酒。稳定 → 建类。·
ChilledWine:一瓶酒放进冰箱就是“冰镇酒”,拿出来就不是。不稳定 → 别建类,用布尔属性。底层原理:类代表的是对象的本质属性,属性值代表的是临时状态。 把一个临时状态提升成类,你会得到一个每天都在“搬家”的分类体系——所有基于它的推理和统计都会失真。
肋骨这个例子说明:“该建类还是该建属性值”没有绝对答案,答案取决于你的应用要说到多细。 同一个解剖学领域,给放射科大夫看的 X 光报告系统和给外科手术规划用的系统,答案可以相反。
4.6这是实例,还是类?
判断某个概念在本体里是类还是个体实例,取决于本体可能的应用是什么。判断“类在哪里结束、个体实例从哪里开始”,第一步是判断表示的最小粒度层级在哪里。而粒度层级又是由本体的潜在应用决定的。换句话说:将要在这个知识库里被表示出来的、最具体的那些条目是什么? 回到第 3 章第 1 步里确定的能力问题:那些将构成这些问题的答案的最具体的概念,就是知识库中“个体实例”的极佳候选。
个体实例是知识库里所表示的最具体的概念。
比如,如果我们只打算谈论“酒配什么食物”,那我们不会对一瓶瓶具体的酒感兴趣。因此,像 Sterling Vineyards Merlot 这样的词,很可能就是我们用到的最具体的术语。换句话说,Wine 类不是一瓶瓶具体葡萄酒的集合,而是各个酒庄生产的各款具体酒的集合。因此,Sterling Vineyards Merlot 会是知识库里的一个实例。
反过来说,如果我们除了“酒菜搭配知识库”之外,还要维护餐厅里酒的库存,那么每一瓶酒就可能成为知识库里的个体实例。
同样,如果我们想为 Sterling Vineyards Merlot 的每一个具体年份记录不同的属性,那么该酒的具体年份是知识库里的一个实例,而 Sterling Vineyards Merlot 则是一个类,它包含各个年份的实例。
从实例“上升”为类的一条规则
还有一条规则可以把某些个体实例提升到类的集合里:
如果概念之间构成天然的层次,就应该把它们表示为类。
以酒产区为例。一开始我们可能把主要产区(法国、美国、德国等)定义成类,把这些大区域里的具体产区定义成实例。比如 Bourgogne region(勃艮第产区)是“法国产区”类的一个实例。但是,我们还想说 Cotes d'Or region 是一个勃艮第产区。因此 Bourgogne region 必须是一个类(这样才能有子类或实例)。然而,把 Bourgogne region 做成类、把 Cotes d'Or region 做成 Bourgogne region 的实例,看起来很随意:很难清楚地划分哪些产区是类、哪些是实例。因此,我们把所有酒产区都定义为类。 Protégé-2000 允许用户把某些类标记为 Abstract(抽象类),表示这个类不能有直接实例。在我们的例子里,所有产区类都是抽象类(图 8)。
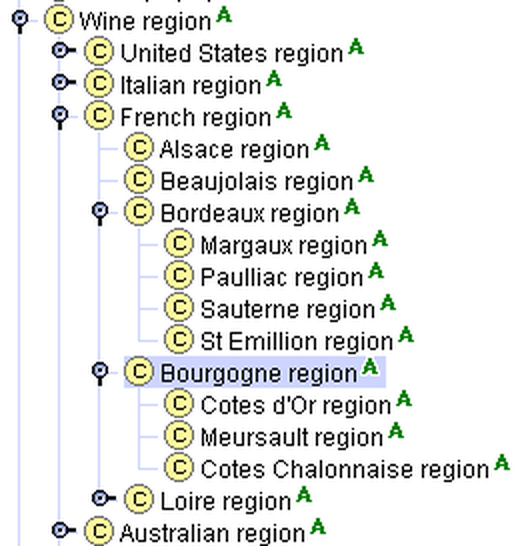
如果我们在类名里省掉“region”(产区)这个词,同一个类层次就会变成错的。 我们不能说 Alsace 类是 France 类的子类:阿尔萨斯不是法国的一种。但 Alsace region 是 French region 的一种。
只有类才能被组织成层次——知识表示系统里没有“子实例”这个概念。 因此,如果术语之间存在天然的层次关系(比如 4.2 节里那种术语层次),我们就应该把这些术语定义成类,即使它们可能没有自己的任何实例。
·
Bourgogne region 和 Cotes d'Or region 的关系是分类(一个产区是另一个产区的下级),不是示例。所以两个都得是类。· 但如果它们都是类,那“具体某个产区的实例”是什么?——可以没有。 于是把它们标成抽象类。
最后那句“省掉 region 就错了”是神来之笔:
Alsace(一个地名)不是 France(一个国家)的一种,但 Alsace region(一个产区)是 French region(一个法国产区)的一种。同样的层次结构,只因为名字里多了个词,就从错变对了。 这就是 4.1 节“区分类和类的名字”的实战价值。4.7控制范围
作为定义类层次的收尾,下面这组规则在判断“本体什么时候算建完了”时永远管用:
本体不应该包含这个领域所有可能的信息:你不需要比你应用所需更特化(或更泛化)——两个方向各多一层就够了。
就我们的酒与食物例子来说:我们不需要知道酒标用的是什么纸,也不需要知道虾该怎么烧。
同理:本体不应该包含层次中类之间所有可能的属性和区分。
在本书的本体里,我们当然没有包含一款酒或一种食物可能有的全部属性,只表示了本体中各类条目最显著的那些属性。酒类书籍会告诉我们葡萄的大小,我们也没有把这个知识放进去。同样,我们没有把所有能想象到的关系都加进去。比如,我们没有为了“让术语之间的所有互连都表示得更完整”,而在本体里加入 favorite wine(最爱的酒)和 favorite food(最爱的食物)这类关系。
最后这条规则也适用于“已经在本体里的概念之间建立关系”。 考虑一个描述生物学实验的本体。它很可能包含 Biological organisms(生物有机体)这个概念,也会包含一个做实验的 Experimenter(实验者)概念(带姓名、单位等)。诚然,一个实验者作为人,也碰巧是一个生物有机体。但我们大概不应该把这一层纳入本体:就这个表示的目的而言,实验者不是一个生物有机体,我们也永远不大会对实验者本人做实验。如果我们把关于本体中各类能说的一切都表示出来,Experimenter 就会变成 Biological Organism 的子类。但就我们可预见的应用而言,不需要包含这个知识。事实上,为已有类加上这类额外分类,反而有害:现在 Experimenter 的一个实例会带有 weight(体重)、age(年龄)、species(物种)等属性——这些数据与生物有机体有关,但在描述一个实验的语境里完全不相关。
不过,我们应该把这类设计决策记录在本体的文档里,以造福那些将查看这个本体、却可能不了解我们当初设想的是什么应用的用户。否则,打算把这个本体复用到其他应用的人,可能会试图把 experimenter 当作 person 的子类使用,而不知道原始建模里并没有包含这个事实。
Experimenter 是 BiologicalOrganism 的子类——这句话在现实中为真。但放进本体里,你立刻得到两个问题:1. 实例被塞了一堆无关字段:体重、年龄、物种,跟“这个实验用了什么试剂”毫无关系。
2. 误导后来的复用者:他看到
Experimenter 不是 Person 的子类,会以为是漏了,然后“顺手补上”——把你的设计意图搞乱。所以原文的处方是:该省的关系就省,但省下的原因必须写进文档。
4.8互斥子类
很多系统允许我们显式声明若干个类是互斥(disjoint)的。 如果两个类不可能有共同的实例,它们就是互斥的。
比如,本书本体里的 Dessert wine 和 White wine 不互斥:有很多酒同时是这两个类的实例,例如 Sweet Riesling 类的 Rothermel Trochenbierenauslese Riesling 实例。而 Red wine 和 White wine 是互斥的:没有哪款酒能同时是红的和白的。
声明类互斥,能让系统更好地校验本体。 如果我们声明 Red wine 和 White wine 互斥,之后又创建了一个同时是 Riesling(White wine 的子类)和 Port(Red wine 的子类)子类的类,系统就能指出这里存在一个建模错误。
前面 4.1 节说“层次里不该有环”,4.2 节说“兄弟不能在同一个抽象层级”。但机器凭什么知道这两个约束被违反了?靠的就是互斥声明:你告诉机器“红与白不可兼得”,机器就能在你造出一个既红又白的类时报错。
一句话:互斥声明是把“人类常识”翻译成“机器可检验的断言”。
📋八个坑速查
坑 1:单数不是复数的子类
Wines 底下挂 Wine——一款酒不是「酒们」的一种。
坑 2:层次里不能有环
A 是 B 的父类,B 又是 A 的父类 = 宣布等价。
坑 3:兄弟要在同一层
白酒和霞多丽并列——一个是一般概念,一个是具体概念。
坑 4:独生子要警惕
只有一个子类:要么多余,要么本体没建完。
坑 5:子类太多要加层
超过十几个说明缺中间层,但没自然分类就别硬造。
坑 6:冰镇酒不是类
成员天天搬家——它是状态,用布尔属性。
坑 7:为每个区分建类 = 爆炸
颜色 × 酒体 × 风味 × 糖分 = 81 个类。
坑 8:真的东西也该省
实验者是生物有机体为真——但会塞进无关字段。省的原因写进文档。
新类必须「有话可说」:多一个属性、多一条限制、或多一种关系