一套简单的知识工程方法论
先出考卷,再动工;没有标准答案
1先说清楚:没有标准答案
原文开门见山地承认:开发本体不存在唯一的“正确”方法或方法论。 这一章讨论的是通用注意事项,以及一条可行的流程。
流程是迭代式的:先粗粗地过一遍,做出一个毛坯;然后反复修、反复细化,把细节填进去。过程中会讨论建模者需要做的各种决策,以及不同方案的利弊和影响。
原文先立了三条基本原则,说它们“可能显得有点教条”,但确实能在很多情况下帮你做决定:
原则 1:建模一个领域没有唯一正确的方式——永远存在可行的替代方案。 最好的解法几乎总是取决于你心里的应用是什么,以及你预期的扩展方向。
原则 2:本体开发必然是一个迭代过程。
原则 3:本体里的概念应该贴近你关注领域中的(物理或逻辑)对象和关系。 在描述你的领域的句子里,这些概念最可能表现为名词(对象)或动词(关系)。
也就是说,“这个本体打算用来干什么”和“要做到多细或多粗”这两个决定,会一路指导后面所有的建模选择。
在几个都可行的方案里,要挑出对预期任务更合适、更直观、更易扩展、更好维护的那个。同时要记住:本体是现实世界的模型,本体里的概念必须反映这个现实。 做出初版之后,把它放到应用或问题求解方法里去用、或者拿去和领域专家讨论(或者两者都做),以此来评估和调试它。结果几乎必然是要返工的——这种迭代设计会贯穿本体的整个生命周期。
1. 没有标准答案——所以别追求“完美本体”,追求“对我的应用够用的本体”。
2. 一定要返工——所以别想着一次做对,先把骨架搭出来,用了再说。
3. 概念从名词动词里找——写一段话描述你的领域,把名词圈出来当类、动词圈出来当属性,八九不离十。
2第 1 步:确定本体的领域和范围
建议从定义领域和范围开始。具体就是回答四个问题:
- 这个本体要覆盖什么领域?
- 我们打算拿它干什么?
- 本体里的信息应该能回答哪几类问题?
- 谁来用、谁来维护这个本体?
这四个问题的答案在开发过程中可能会变,但在任何一个时刻,它们都能帮你圈定模型的边界。
拿酒与食物的本体来说:领域是“食物和酒”;我们打算用它来做一个“推荐酒菜搭配”的应用。
于是,描述各类酒、主要食物类型、以及“搭配得好”和“搭配得差”这些概念的词,自然就进了本体。同时,管理酒庄库存、管理餐厅员工这些概念,虽然和酒与食物有点关系,但基本不会进本体。
范围变化会直接改变本体的内容,原文举了几个很说明问题的例子:
| 如果本体的用途是…… | 就必须包含…… |
|---|---|
| 辅助处理酒类杂志文章的自然语言 | 同义词、词性信息 |
| 帮餐厅顾客决定点哪款酒 | 零售价格信息 |
| 帮买手采购酒窖存货 | 批发价和货源信息 |
| 维护者与使用者语言不同 | 两种语言之间的映射 |
能力问题:给本体出一份“考卷”
确定范围的一个办法,是先草拟一张问题清单——一个基于该本体的知识库应该能够回答的问题,这叫做能力问题(competency question,出自 Gruninger & Fox, 1995)。
这些问题之后会充当“试金石”:本体里的信息够不够回答这一类问题?要回答它们,是不是需要某个特定层级的细节,或者需要对某个特定区域做建模?
原文强调:这份清单只是个草图,不需要穷尽。
酒与食物领域的能力问题,原文列了这么几条:
- 选酒时我应该考虑哪些酒的属性?
- 波尔多是红酒还是白酒?
- 赤霞珠配海鲜合适吗?
- 配烤肉选什么酒最好?
- 酒的哪些特性会影响它和某道菜的搭配?
- 某款酒的香气或酒体会随年份变化吗?
- 纳帕仙粉黛哪几个年份好?
从这张清单就能反推出本体该装什么:各类酒的属性和酒的类型、年份(好年份和差年份)、对选酒有影响的食物分类、推荐的酒菜搭配组合。
3第 2 步:先看看别人造过没有
几乎总是值得先看看别人做过什么,检查一下能不能拿现成的来源改造扩展,来满足自己这个领域和任务。有三种情况:
- 必须复用:如果你的系统需要和别的应用交互,而那些应用已经绑定了某些本体或受控词表,那复用就是硬性要求。
- 可以导入:很多本体已经有电子版,可以直接导入你用的本体开发环境。
- 格式不是障碍:本体用什么形式化语言表达,通常不重要——很多知识表示系统都能导入导出本体。就算某个系统不能直接处理某种形式化语言,把本体从一种形式化语言翻译成另一种,通常也不是难事。
本体库的现成资源,原文点了几个:
| 名称 | 说明 |
|---|---|
| Ontolingua ontology library | 斯坦福 KSL 的本体库 |
| DAML ontology library | DAML 官方本体库 |
| UNSPSC | 联合国/邓白氏的产品服务分类(可商用) |
| RosettaNet | 电子元件行业标准 |
| DMOZ | 开放目录项目 |
原文举了个例子:一个“法国葡萄酒”的知识库可能已经存在了。如果能把它以及它背后的本体导入进来,你得到的不仅是法国酒的分类,还包括一份区分和描述这些酒时用到的酒属性分类的初版。酒的属性清单,可能从 www.wines.com 这类顾客用来买酒的商业网站上就能拿到。
不过——这本书往下的所有内容,都假设现成本体不存在,从零开始建。
4第 3 步:把重要术语列出来
列一张清单,写下所有你想对它说点什么、或者想向用户解释的术语。问自己三个问题:
- 我们想谈论哪些术语?
- 这些术语有哪些属性?
- 关于这些术语,我们想说什么?
以酒为例,重要术语包括:wine(酒)、grape(葡萄品种)、winery(酒庄)、location(产地)、酒的 color(颜色)、body(酒体)、flavor(风味)、sugar content(含糖量);还有不同类型的食物,比如 fish(鱼)和 red meat(红肉);以及酒的子类型,比如 white wine(白葡萄酒),等等。
原文特别强调这一步的纪律:
先拿到一份全面的术语清单,先别管它们所代表的概念之间有没有重叠、术语之间有什么关系、概念可能有哪些属性、以及这些概念到底是类还是属性。
接下来两步——建类层次、定义属性——是紧密交织的。很难先做完其中一个再做另一个。通常的节奏是:先定义层次里的一批概念,然后接着描述这些概念的属性,如此往复。这两步也是本体设计过程中最重要的两步。
5第 4 步:定义类和类层次
建类层次有三种思路(Uschold & Gruninger, 1996):
(1)自顶向下(top-down)
从领域里最一般的概念开始定义,然后逐步特化。比如先建 Wine 和 Food 两个大类,然后细化 Wine,造出子类 White wine、Red wine、Rosé wine;再往下把 Red wine 分成 Syrah、Red Burgundy、Cabernet Sauvignon 等等。
(2)自底向上(bottom-up)
从最具体的类开始——也就是层次的叶子节点——然后把它们归并成更一般的概念。比如先定义 Pauillac 和 Margaux 两个类;然后为它们造一个共同的父类 Medoc;而 Medoc 又是 Bordeaux 的子类。
(3)中间开花(combination)
前两种的结合:先定义最显著的概念,然后该泛化的泛化、该特化的特化。 比如先起几个顶层概念如 Wine,再起几个具体概念如 Margaux;然后把它们挂到一个中间层概念 Medoc 上;接着可能想从“法国”生成所有地区性的酒类,于是又批量生成一批中间层概念。
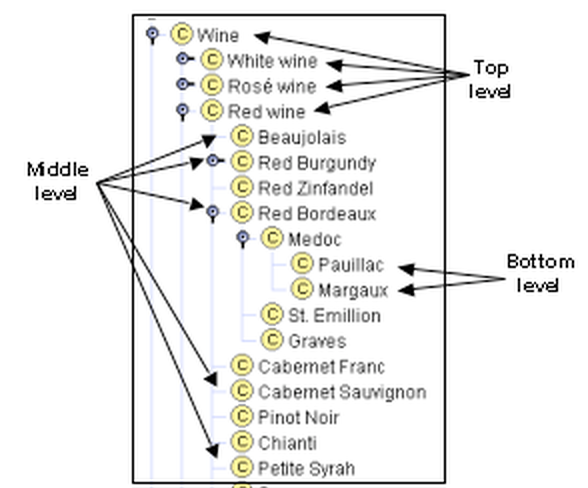
Wine 分类法的不同层次:Wine 是最一般的概念;Red wine、White wine、Rosé wine 是通用顶层概念;Pauillac 和 Margaux 是层次中最具体的类(也就是底层概念)。Beaujolais、Red Burgundy、Cabernet Sauvignon 这些就是“中间层概念”。原文后面会说,中间层往往是最好用的那一层。三种方法没有谁天生更好。 选哪种,强烈依赖你对这个领域的个人视角:如果你对领域有系统性的自顶向下视角,自顶向下可能更顺手;中间开花往往对多数本体开发者最省事,因为“处在中间”的概念,往往正是领域里最具描述性的概念(Rosch, 1978)。
如果你习惯先拿到具体例子才踏实,那就自底向上。
不管选哪种,通常都从定义类开始。 具体做法是:从第 3 步那份清单里,挑出描述“独立存在的对象”的术语,而不是描述这些对象的术语。这些术语成为本体里的类,成为类层次里的锚点。
〔译注〕原文脚注 2 给了一个更形式化的视角:类也可以看成“一元谓词”——只有一个参数的问题。比如“这个对象是酒吗?”。一元谓词(也就是类)和二元谓词(也就是属性)相对——后者有两个参数,比如“这个对象的风味浓吗?”“这个对象的风味是什么?”
挑出类之后,怎么把它们组织成层次? 原文给的判据只有一句话:
如果类 A 是类 B 的父类,那么 B 的每一个实例也都是 A 的实例。
换句话说,类 B 代表的概念是 A 的一种(a kind of)。
比如:每一款黑皮诺(Pinot Noir)必然是红葡萄酒,所以 Pinot Noir 类是 Red Wine 类的子类。
这一步和下一步是一体的——先定义一批类,再回过头描述这些概念的属性,然后再定义类……如此往复。
6第 5 步:定义类的属性
光有类,回答不了第 1 步那些能力问题。一旦定义了类,就必须描述概念的内部结构。
第 3 步的清单里,挑走“类”之后,剩下的术语大多就是这些类的属性。比如酒的颜色、酒体、风味、含糖量,以及酒庄的位置。
对清单里每一条属性,都要确定它描述的是哪个类。这些属性变成挂在类上的属性。于是:Wine 类有这些属性:color、body、flavor、sugar;Winery 类有一个 location 属性。
原文把可以变成属性的对象属性分成四类:
| 属性种类 | 含义 | 例子 |
|---|---|---|
| 内在(intrinsic) | 对象自身固有的性质 | 酒的风味 |
| 外在(extrinsic) | 对象与外部的关联中体现的性质 | 酒的名字、来自哪个产区 |
| 部分(parts) | 对象有结构时的组成部分,物理的和抽象的都有 | 一顿饭的几道菜 |
| 指向其他个体的关系 | 类的某个个体成员与其他条目之间的关系 | 酒的 maker、酒用的 grape |
因此,除了前面已识别的属性,还需要给 Wine 类加上这些属性:name、area、maker、grape。
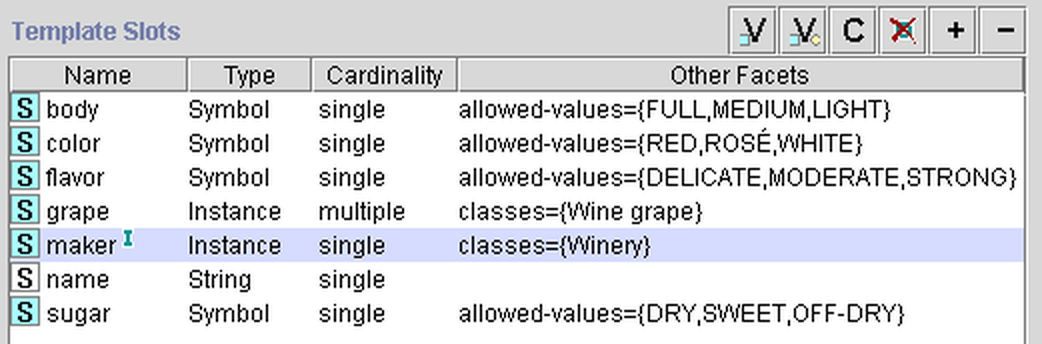
Wine 类的属性,以及这些属性的约束(facets)。maker 属性旁边的 “I” 图标表示这个属性有逆属性(见 5.1 节)。Wine 类的“参数表”。四个关键列:· Name:属性叫什么(body / color / flavor / grape / maker / name / sugar)
· Type:值的类型(Symbol 符号型、Instance 实例型、String 字符串型)
· Cardinality:能填几个值(single 单个 / multiple 多个)
· Other Facets:更细的约束。比如
body 只允许填 FULL, MEDIUM, LIGHT 三者之一留意
maker 那一行左边那个 “I”——它标记了这个属性有逆属性,后面 5.1 节全靠它。继承:属性往下传
一个类的所有子类,都继承该类的属性。 比如 Wine 类的所有属性,会继承给 Wine 的所有子类,包括 Red Wine 和 White Wine。
我们可以给 Red Wine 类额外加一个属性 tannin level(单宁含量:low / moderate / high)。这个属性会被所有代表红酒的类(比如 Bordeaux 和 Beaujolais)继承。
属性该挂在哪一层:挂在“能挂的最高层”
这是一条容易做错的规则:
一个属性应该挂在“能够拥有该属性的最一般的类”上。
比如酒的 body 和 color 应该挂在 Wine 类上——因为 Wine 就是“其实例会有酒体和颜色”的最一般的类。
7第 6 步:定义属性的约束
属性可以有各种各样的约束(facet),用来描述:值的类型、允许的取值、值的个数(基数 cardinality),以及这个属性能取的值的其他特征。
举个例子:name 属性(“酒的名字”)的值是一个字符串——即 name 是一个值类型为 String 的属性。produces 属性(“酒庄生产这些酒”)可以有多个值,且这些值是 Wine 类的实例——即 produces 是一个值类型为 Instance、允许类为 Wine 的属性。
约束之一:属性的基数(Cardinality)
基数定义了属性能取几个值。 有些系统只区分单基数(最多一个值)和多基数(任意多个值)。酒的 body 是单基数属性——一款酒只能有一个酒体。某家酒庄生产的酒,填的是 Winery 类 produces 这个多基数属性。
有些系统允许指定最小基数和最大基数,把取值个数描述得更精确:最小基数为 N:这个属性至少有 N 个值。比如 Wine 的 grape 属性最小基数为 1——每款酒至少由一种葡萄酿成。最大基数为 M:这个属性至多有 M 个值。对单一品种酒来说,grape 属性的最大基数是 1——这些酒只由一种葡萄酿成。最大基数设为 0 有时很有用:表示在某个特定子类里,这个属性不能有任何值。
约束之二:属性的值类型(Value Type)
值类型的约束描述什么类型的值可以填进这个属性。常见的几种:
| 值类型 | 说明 | 例子 |
|---|---|---|
| String(字符串) | 最简单的值类型 | name 的值就是一个简单字符串 |
| Number(数值) | 数值型,有时细分为 Float / Integer | 酒的价格可以是 Float |
| Boolean(布尔) | 是/否开关 | true 就是起泡酒,false 就不是 |
| Enumerated(枚举) | 预先限定一组允许值 | flavor 只能在 strong、moderate、delicate 里取一个 |
| Instance(实例) | 定义个体之间的关系 | produces 属性的值可以是 Wine 类的实例 |
〔译注〕原文脚注 3:有些系统直接用“类的值类型”来指定,而不需要专门声明“实例型属性”。
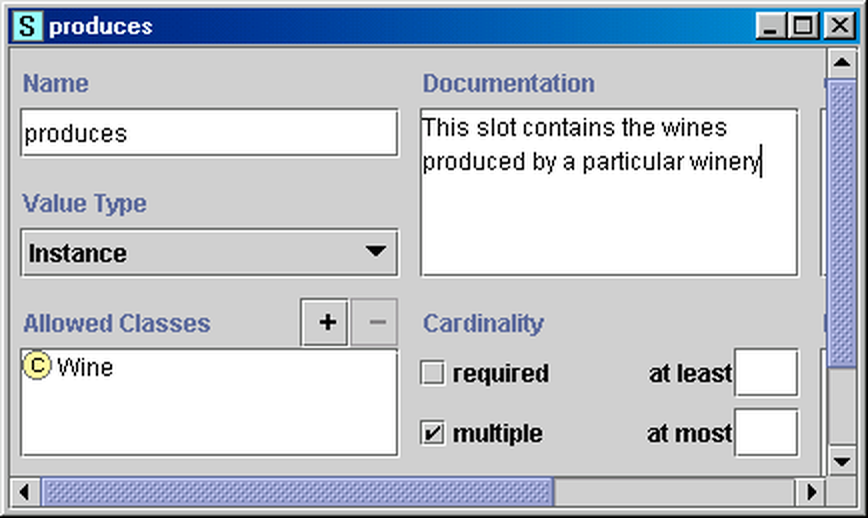
produces 属性的定义,用来描述某家酒庄生产哪些酒。这个属性的基数是 multiple(多个),值类型是 Instance(实例),允许类(allowed class)是 Wine。· Value Type = Instance:说明这个属性填的不是文字、不是数字,而是另一个对象。
· Allowed Classes = Wine:光说“填个对象”还不够,还得说清“填哪一类对象”。
· Cardinality 里勾了 multiple:一家酒庄当然不止产一款酒。
约束之三:属性的 Domain(定义域)和 Range(值域)
值域(Range):实例型属性的“允许类”通常就叫这个属性的值域。图 4 里,Wine 类就是 produces 属性的值域。有些系统允许在属性被挂到某个特定类上时,进一步限制它的值域。
定义域(Domain):属性所挂载的类,或者说这个属性描述的是哪个类的属性,叫做这个属性的定义域。Winery 类就是 produces 属性的定义域。在“把属性挂在类上”的这类系统里,属性挂到哪些类上,这些类通常就构成了该属性的定义域,不需要另外单独指定。
确定定义域和值域的基本规则是相似的:
在给一个属性定义定义域或值域时,找出能够分别充当该属性定义域或值域的最一般的那个(那些)类。
另一方面,不要把定义域和值域定义得过泛:属性的定义域里的所有类都应该确实由该属性来描述;属性的值域里所有类的实例都应该确实是该属性的潜在填充值。不要为值域选一个过泛的类(比如,不该把值域设成 THING),而要选一个能覆盖所有填充值的类。
换成更具体的说法,有三条化简规则。原文的表述是:与其把 produces 的值域列成 Wine 的所有子类,不如只写 Wine。
规则一:如果定义某个属性值域(或定义域)的类列表里,同时包含了一个类和它的子类,就删掉子类。如果 produces 的值域里同时有 Wine 和 Red Wine,就把 Red Wine 删掉——它没有增加任何新信息:Red Wine 是 Wine 的子类,因此值域已经隐式地包含了它,也包含了 Wine 的所有其他子类。
规则二:如果定义值域(或定义域)的类列表里包含了某个类 A 的所有子类,但没有包含 A 本身,那么值域应该只写 A,不写那些子类。与其把 produces 的值域写成 Red Wine、White Wine、Rose Wine(把 Wine 的直接子类一个个列出来),不如直接把值域限制为 Wine 类本身。
规则三:如果列表里包含了某个类 A 的除少数几个之外的全部子类,考虑一下是不是用 A 做值域更合适。
在那些“把属性挂到类上”就等同于“把该类加入属性的定义域”的系统里,同样的规则也适用于属性的挂载:一方面,我们应该尽量挂得一般;另一方面,必须确保每个挂了该属性的类,都确实能拥有该属性所代表的那个属性。
我们本可以把 tannin level(单宁含量)属性挂到每一个代表红酒的类上(Bordeaux、Merlot、Beaujolais 等等)。但既然所有红酒都有单宁含量这个属性,就应该把它挂到 Red Wines 这个更一般的类上。再往上泛化一步——把 tannin level 挂到 Wine 类上——就不对了,因为我们不用单宁含量来描述白葡萄酒。
“挂在能挂的最高层”这条规则的边界是:不能出现假命题。
Wine 是一个能挂 tannin level 的候选位置,但挂上去就等于断言“每款酒都有单宁含量”——而白酒没有。所以正确答案是 Red Wine 这一层:再往上一步就错了,再往下一步就冗余了。三条化简规则其实都在讲同一件事:类层次本身就是“包含关系”的压缩表达。 既然
Red Wine 已经隐含在 Wine 之下,再把它单列一遍就是重复劳动,而且以后容易改漏。8第 7 步:创建实例
最后一步是创建层次中各个类的个体实例。定义一个个体实例需要三步:选一个类;创建该类的一个个体实例;填写属性的值。
原文的例子:创建一个个体实例 Chateau-Morgon-Beaujolais,代表某款具体的博若莱酒。Chateau-Morgon-Beaujolais 是 Beaujolais 类(代表所有博若莱酒)的一个实例。这个实例的属性值如下:
| 属性 | 值 |
|---|---|
Body(酒体) | Light(轻) |
Color(颜色) | Red(红) |
Flavor(风味) | Delicate(清淡) |
Tannin level(单宁含量) | Low(低) |
Grape(葡萄) | Gamay(佳美,Wine grape 类的实例) |
Maker(生产者) | Chateau-Morgon(Winery 类的实例) |
Region(产区) | Beaujolais(Wine-Region 类的实例) |
Sugar(糖分) | Dry(干型) |
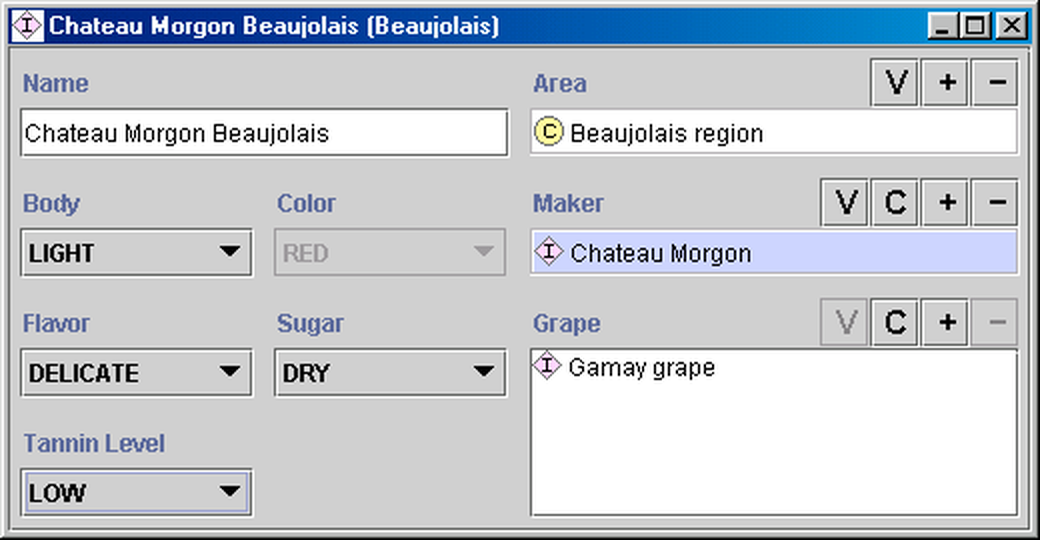
Beaujolais 类的一个实例的定义。这个实例是来自博若莱产区的 Chateaux Morgon Beaujolais,由佳美葡萄酿成、由 Chateau Morgon 酒庄生产。它的酒体轻、风味清淡、颜色红、单宁含量低,是一款干型酒。· 图 4 是类的属性定义:配置属性本身(值类型是实例、允许类是
Wine、基数是多个)。· 图 5 是实例的填值:
Name 填了 Chateau Morgon Beaujolais,Area 指向 Beaujolais region 这个对象。注意图 5 里每个字段前面的小图标:有的是菱形(
I,instance,指向另一个对象),有的是下拉框(枚举值,如 LIGHT/DELICATE/DRY)。这一张表就是第 7 步的全部产出。